

 JustApt
Bir rol için değerlendirme hazırlamak eskiden uzman ekiplerin haftalarını alıyordu. Sorular elle yazılıyor, yetkinliklerle tek tek eşleştiriliyor, gözden geçiriliyor; sonra bir sonraki rol için aynı iş baştan başlıyordu.
JustApt'te yönetici bu süreci kendi cümlesiyle başlatıyor. Ama hikâyenin asıl kahramanı hız değil; hızın, uzman kontrolünü süreçten çıkarmadan nasıl sağlandığı.
Proje kısaca
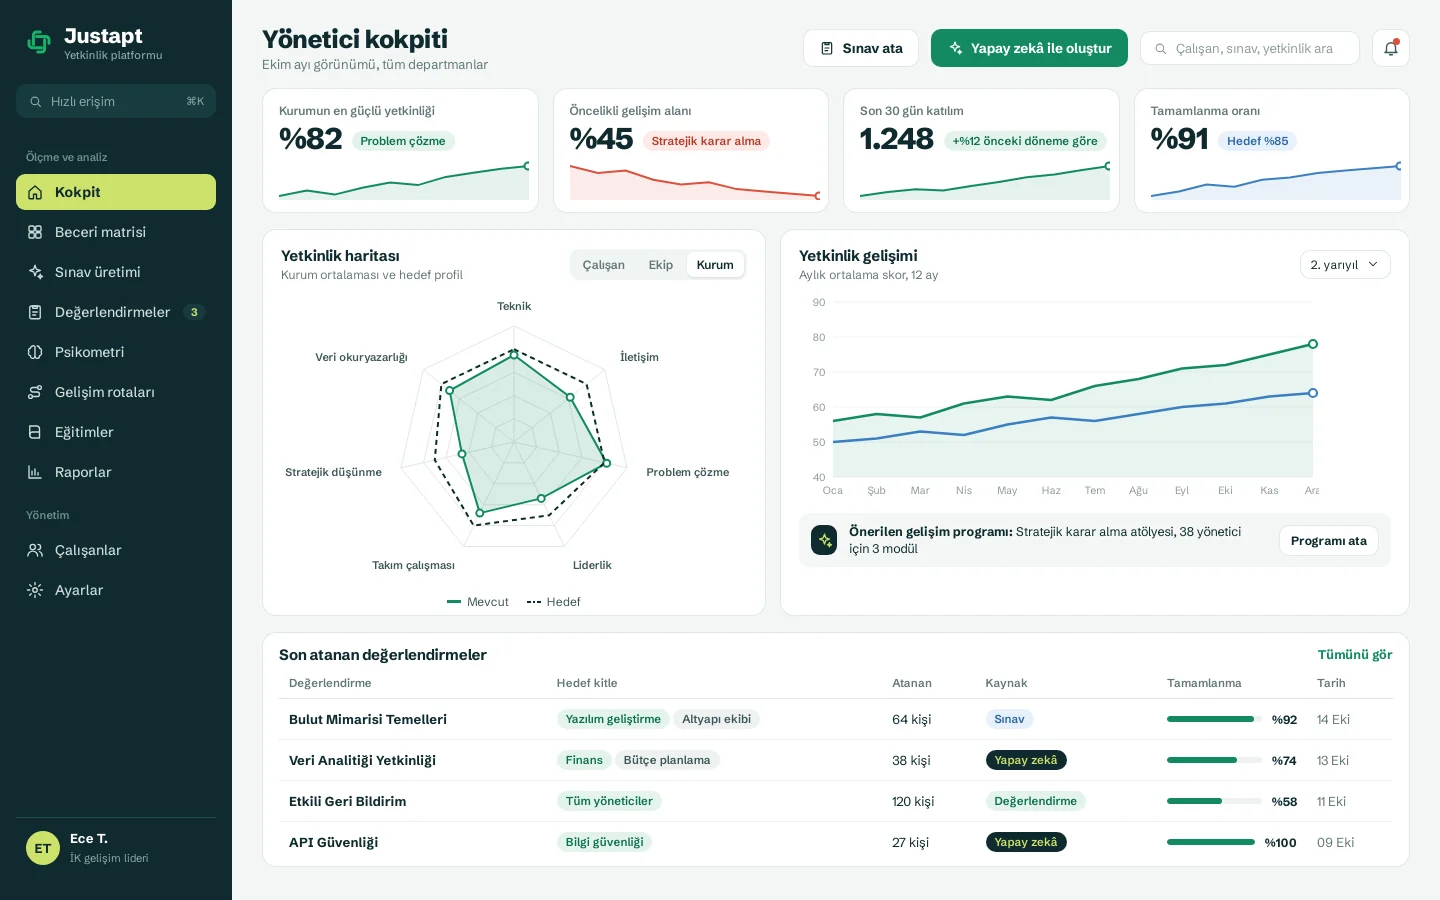
JustApt, binlerce çalışanı olan bir kurum için geliştirdiğimiz yapay zekâ destekli yetkinlik ölçüm ve gelişim platformu. Çalışanların teknik ve davranışsal yetkinliklerini ölçüyor, rolün beklediği seviyeyle arasındaki boşluğu gösteriyor ve bu boşluğu kapatacak gelişim rotasını oluşturuyor. Sınav üretimi, psikometrik ölçüm, yetkinlik analitiği ve öğrenme yönetimi aynı çatı altında, beş seviyeli ortak bir yetkinlik sözlüğü üzerinde çalışıyor. Yönetici kokpitinde sınav atamak da yapay zekâ ile yeni bir sınav oluşturmak da tek tık uzaklıkta.
Beş adımda sınav: komut, analiz, hazır set
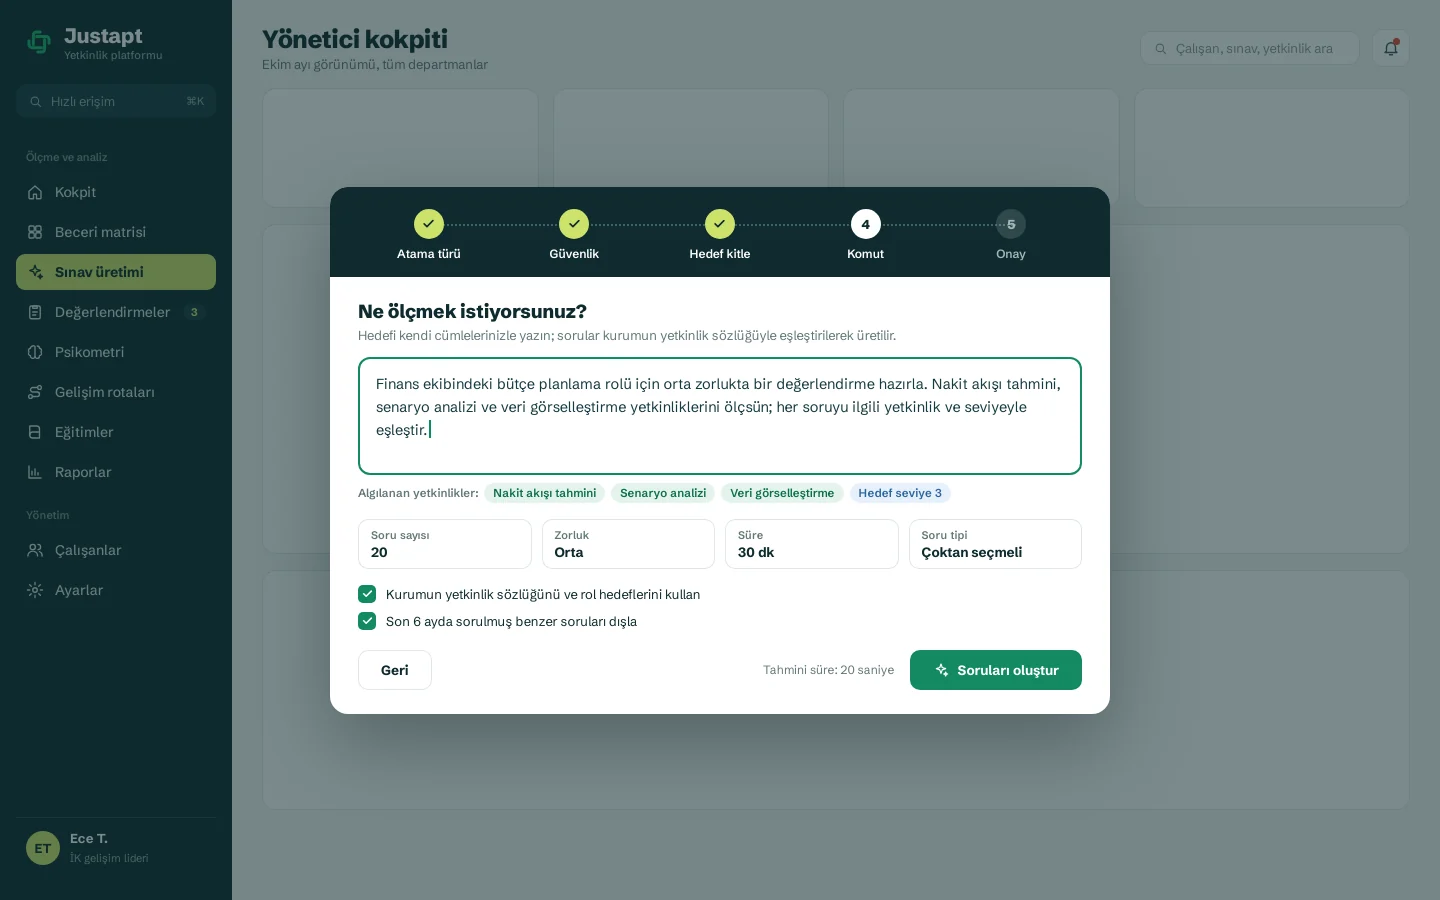
Sınav üretimi beş adımlı bir sihirbazla ilerliyor: atama türü, güvenlik seviyesi, hedef kitle, komut ve onay. Komut adımında yönetici ölçmek istediği şeyi kendi cümlesiyle yazıyor. Sistem yetkinlik sözlüğünü, rol hedeflerini ve soru havuzunu tarıyor; metinden ilgili yetkinlikleri algılayıp üretim ayarlarıyla birlikte yöneticinin önüne koyuyor. Onay verildiğinde, her biri bir yetkinliğe ve seviyeye bağlı sorular saniyeler içinde incelemeye hazır oluyor.
Sorunun bir yetkinliğe bağlı olması ayrıntı gibi görünse de sistemin bütün değeri buradan geliyor. Çünkü sonuçlar daha sonra beceri matrisine, kariyer basamaklarına ve gelişim rotalarına bu bağ üzerinden akıyor. Yetkinliğe bağlanmamış bir soru, ne kadar iyi yazılmış olursa olsun, analize hiçbir şey katmıyor.
Sınav, daha geniş bir zincirin ortasında duruyor. Kullanıcının attığı her adımın arkasında sistemin yürüttüğü bir iş var: İK envanteri teslim edildiğinde kurum matrisi modele alınıyor, konu ve kazanım eşleşmesi yetkinlik sözlüğüyle hizalanıyor, sınav seviyeye göre soru seçen uyarlanabilir bir kurguyla hazırlanıyor. Çalışan sınava girdikten sonra kök yetkinlik analizi boşluğun asıl nedenini arıyor, bireysel gelişim haritası oluşuyor ve uzman kontrolünden geçen nihai rapor yayınlanıyor. Bu sekiz adımın hiçbirinde veri elle taşınmıyor.
Yayından önce son söz uzmanda
Otomatik üretilen tek bir yanlış ya da belirsiz soru, bütün değerlendirmeyi tartışmalı hâle getirebilir. Bu yüzden platformun temel kuralı net: sorular yapay zekâ ile üretiliyor ama yayına uzman onayıyla çıkıyor. Hiçbir soru onaysız yayınlanmıyor.
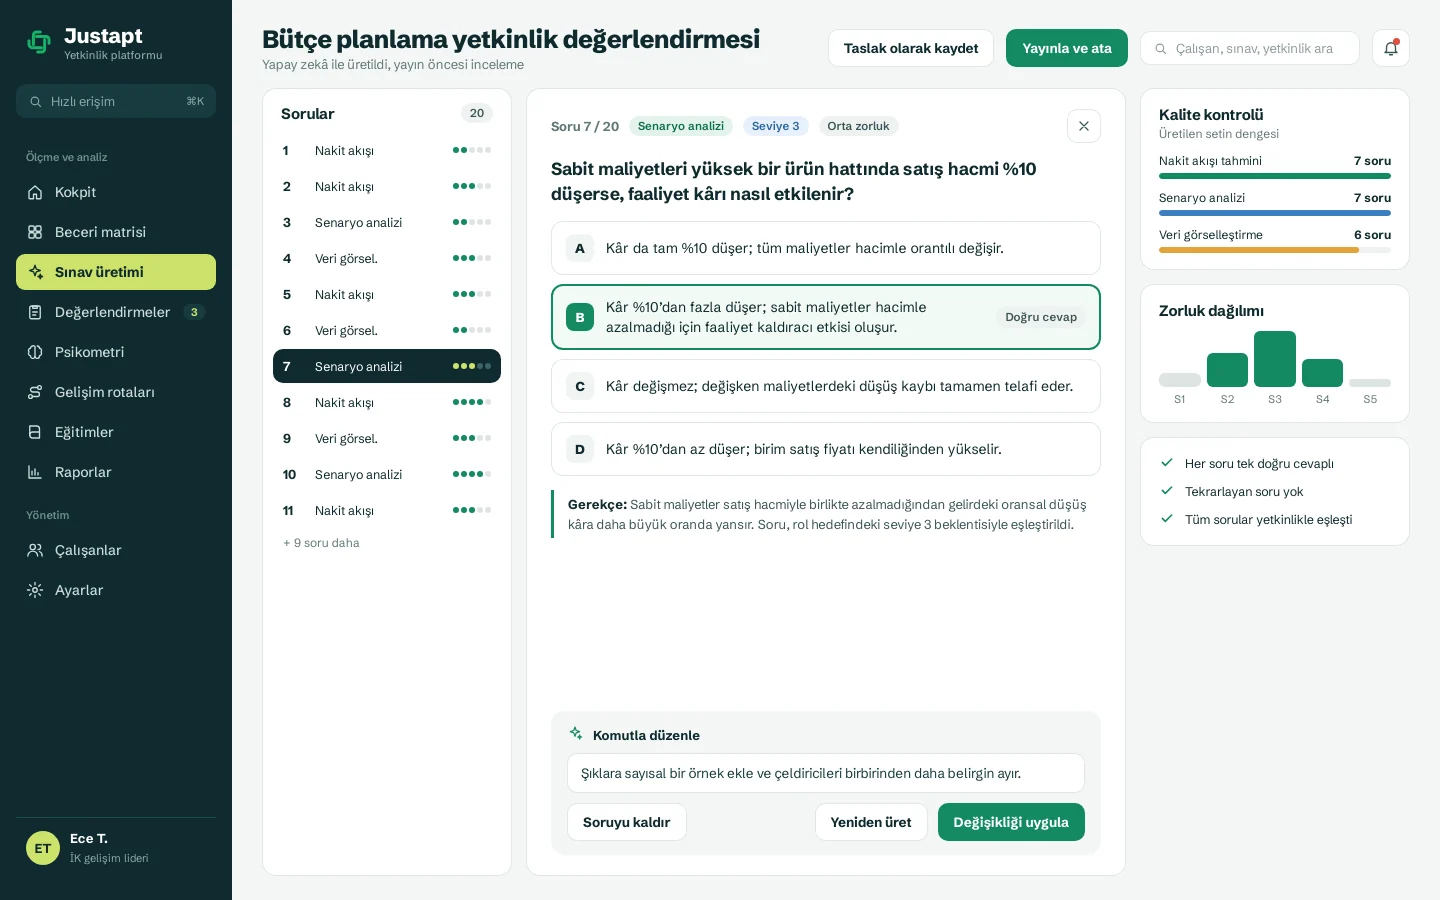
Uzman, soru gezgininde her soruyu tek tek inceliyor. Her sorunun doğru cevabı, gerekçesiyle ve hangi seviyeyi ölçtüğüyle birlikte kayıtlı; gerekçe, sorunun rol hedefindeki hangi seviye beklentisiyle eşleştirildiğini de söylüyor. Beğenilmeyen soru doğal dilde verilen bir komutla düzenleniyor; şıklar, zorluk ya da bağlam bu talimatla güncelleniyor. Gerekirse soru yeniden üretiliyor ya da setten çıkarılıyor.
Aynı ekranda bir kalite kontrol paneli çalışıyor. Her sette yetkinlik dağılımı, zorluk dengesi, tek doğru cevap ve tekrar kontrolü otomatik raporlanıyor. Uzmanın gözü tek bir soruya odaklanmışken setin bütününe dair resmi kaçırmaması için bu panel kritik. Set hazır olduğunda uzman onu taslak olarak saklayabiliyor ya da tek adımda yayınlayıp hedef kitleye atayabiliyor.
Uygulama anı: esnek mi, gözetimli mi?
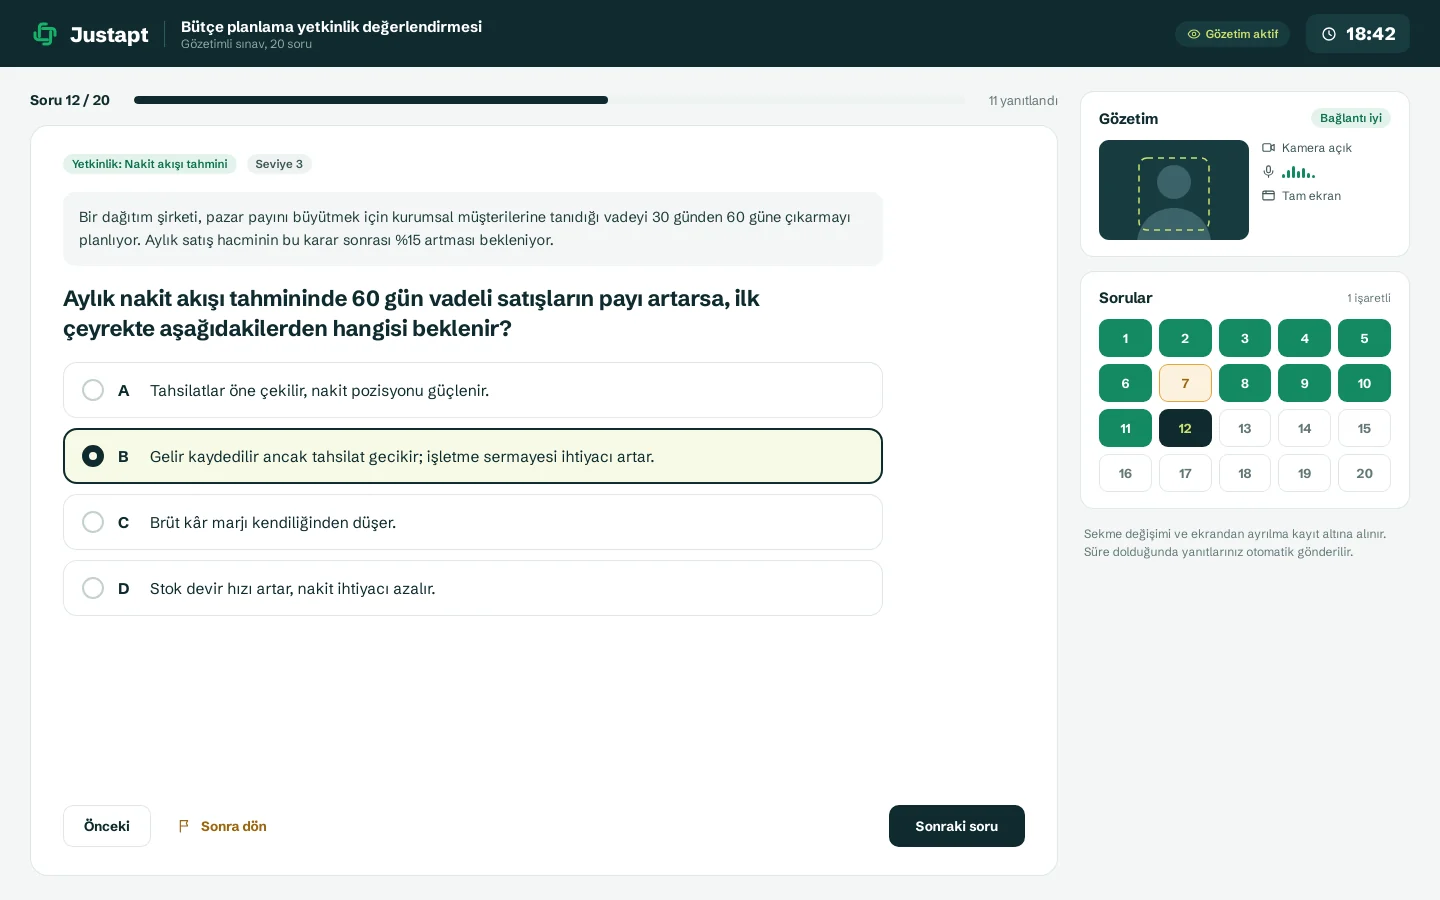
Sınavın güvenilirliği de amaca göre ayarlanabilmeliydi. Terfi ve işe alım gibi kritik kararlarda sonuçların kopyaya ve dış yardıma karşı korunması gerekiyor; gelişim amaçlı ölçümlerde ise aynı sıkılık gereksiz bir sürtünme yaratıyor. Bu yüzden güvenlik seviyesi sihirbazın bir adımı: esnek mod ya da kamera, mikrofon, tam ekran ve sekme takibi içeren gözetimli mod. Sekme değişimi, ekrandan ayrılma ve süre aşımı otomatik işleniyor.
Çalışan tarafında ekran sade: süre sayacı, soru haritası ve önünde tek bir soru. Ekran, platformun geri kalanı gibi WCAG 2.1 AA erişilebilirlik ölçütlerine uygun ve ekran okuyucu dostu tasarlandı. Her yanıt anında sunucuya yazılıyor; bağlantı kopsa da hiçbir cevap kaybolmuyor. Sınav, adayın verdiği yanıtlara göre de şekillenebiliyor: orta seviyedeki bir soruyu doğru yanıtlayan adaya bir sonraki adımda daha zor bir soru gelebiliyor. Sonuçlar ise kendiliğinden beceri matrisine ve kariyer basamaklarına yansıyor. Raporda sorular türlerine göre de ayrışıyor: genel yetkinlik, stratejik düşünme, problem çözme ve analitik düşünme soruları ayrı ayrı değerlendiriliyor, zorluk seviyesine göre başarı da ayrıca görünüyor. Bilgi sınavlarının yanında kişilik, dayanıklılık ve bilişsel yetenek ölçekleri de aynı platformda uygulanıyor; puanlama mantıkları farklı olduğu için ayrı algoritmalarla hesaplanıp tek aday raporunda birleşiyorlar.
Sahada öğrendiklerimiz
- Yapay zekâ hızlandırır, uzman karar verir. Üretimi otomatikleştirip yayını onaya bağlamak, hem hızı hem güveni korudu.
- Her soru bir yetkinliğe bağlı olmalı. Sözlüğe bağlanan soru, sınavdan sonra da değer üretmeye devam ediyor.
- Gerekçe sorunun parçasıdır. Doğru cevabın neden doğru olduğunu ve hangi seviyeyi ölçtüğünü kaydetmek, gözden geçirmeyi kolaylaştırıyor.
- Güvenlik amaçla orantılı olmalı. Gelişim ölçümünde esnek, kritik kararda gözetimli mod; ikisi aynı platformda.
Bir değerlendirmenin değeri en zayıf sorusu kadardır. Yapay zekâyı kullanmanın doğru yolu, o zayıf soruyu yayına çıkmadan yakalayan süreci de birlikte kurmaktır.
Değerlendirmeleriniz ne kadar sürede hazırlanıyor?
Değerlendirme hazırlığı uzman ekiplerinizin haftalarını alıyorsa ya da yapay zekâyı kullanmak isteyip kontrolü kaybetmekten çekindiğiniz bir süreciniz varsa, insan onaylı bir üretim akışını birlikte tasarlayabiliriz. JustApt proje sayfasına göz atabilir, bize ulaşabilirsiniz.
Yazar hakkında
Selin Kaya
Dijital İçerik Uzmanı
Karatsoft'ta dijital içerik uzmanı olarak blog yazılarını hazırlar. Ürünlerin ve projelerin ne işe yaradığını, nasıl kullanıldığını sade bir dille anlatır.

Yorumlar
0Henüz yorum yapılmamış. İlk yorumu siz yapın!
Yorum Yap
Düşüncelerinizi ve görüşlerinizi bizimle paylaşabilirsiniz.