

 JustApt
كان إعداد تقييم لدور وظيفي يستغرق في السابق أسابيع من فرق الخبراء. فتُكتب الأسئلة يدويًا، وتُربط بالكفاءات واحدًا واحدًا، وتُراجَع؛ ثم يبدأ العمل نفسه من جديد للدور التالي.
في JustApt يبدأ المدير هذه العملية بجملة من عنده. لكن بطل القصة الحقيقي ليس السرعة، بل كيف تحققت هذه السرعة دون إخراج رقابة الخبراء من العملية.
نبذة موجزة عن المشروع
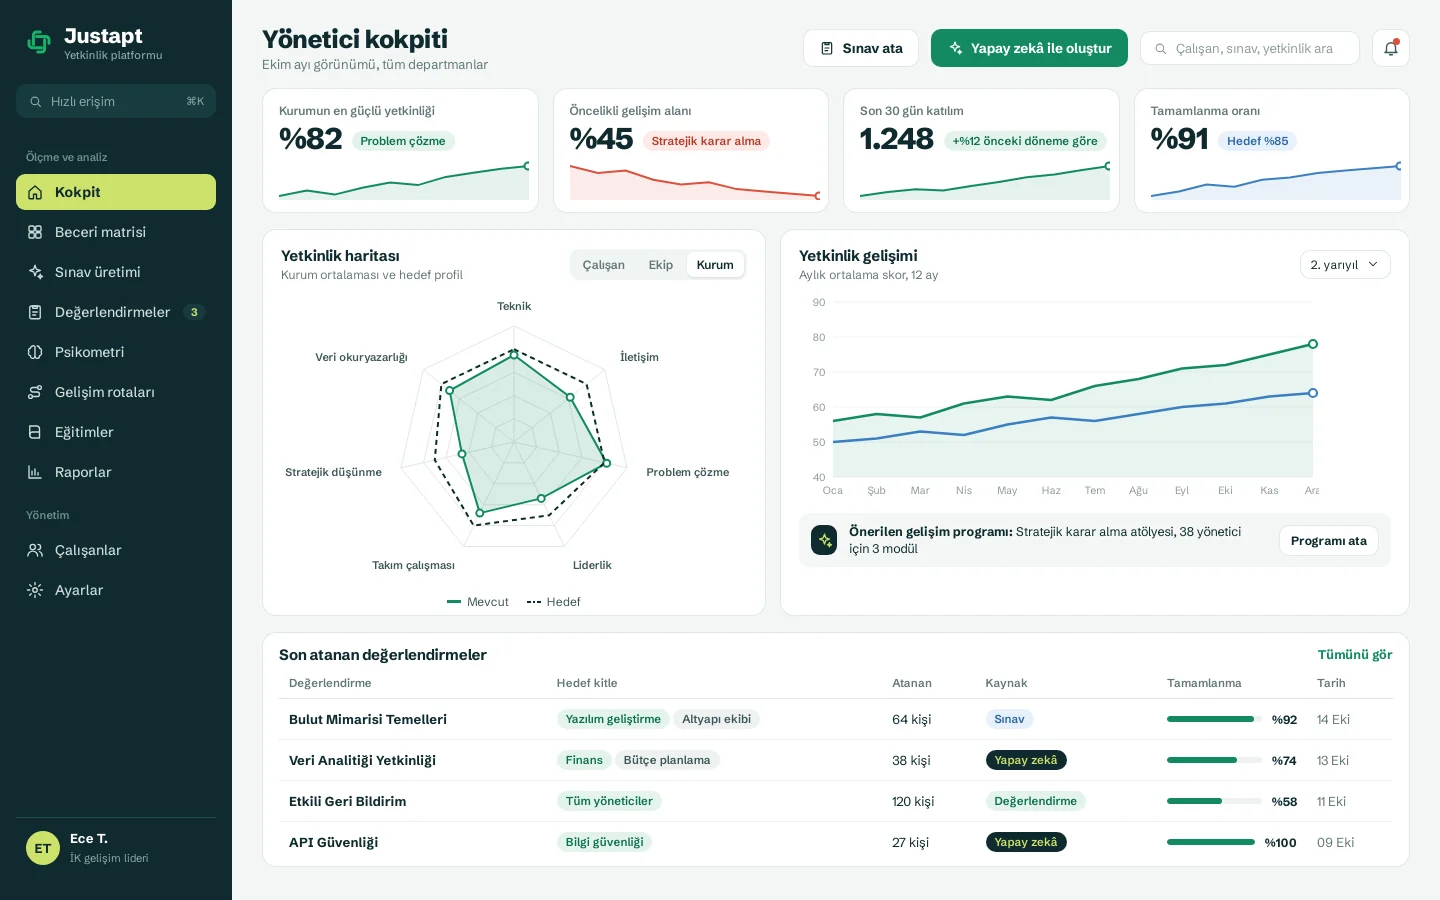
JustApt منصة لقياس الكفاءات وتطويرها مدعومة بالذكاء الاصطناعي، طوّرناها لمؤسسة يعمل فيها آلاف الموظفين. فهي تقيس الكفاءات التقنية والسلوكية للموظفين، وتُظهر الفجوة بين مستوى كفاءاتهم والمستوى الذي يتوقعه الدور، وتُنشئ مسار التطوير الذي يسدّ هذه الفجوة. ويجتمع في المنصة، تحت سقف واحد، إنشاء الاختبارات والقياس السيكومتري وتحليلات الكفاءات وإدارة التعلّم، وكلها تعمل على قاموس كفاءات مشترك من خمسة مستويات. وفي لوحة قيادة المدير، إسناد اختبار أو إنشاء اختبار جديد بالذكاء الاصطناعي على بُعد نقرة واحدة.
اختبار في خمس خطوات: الأمر والتحليل والمجموعة الجاهزة
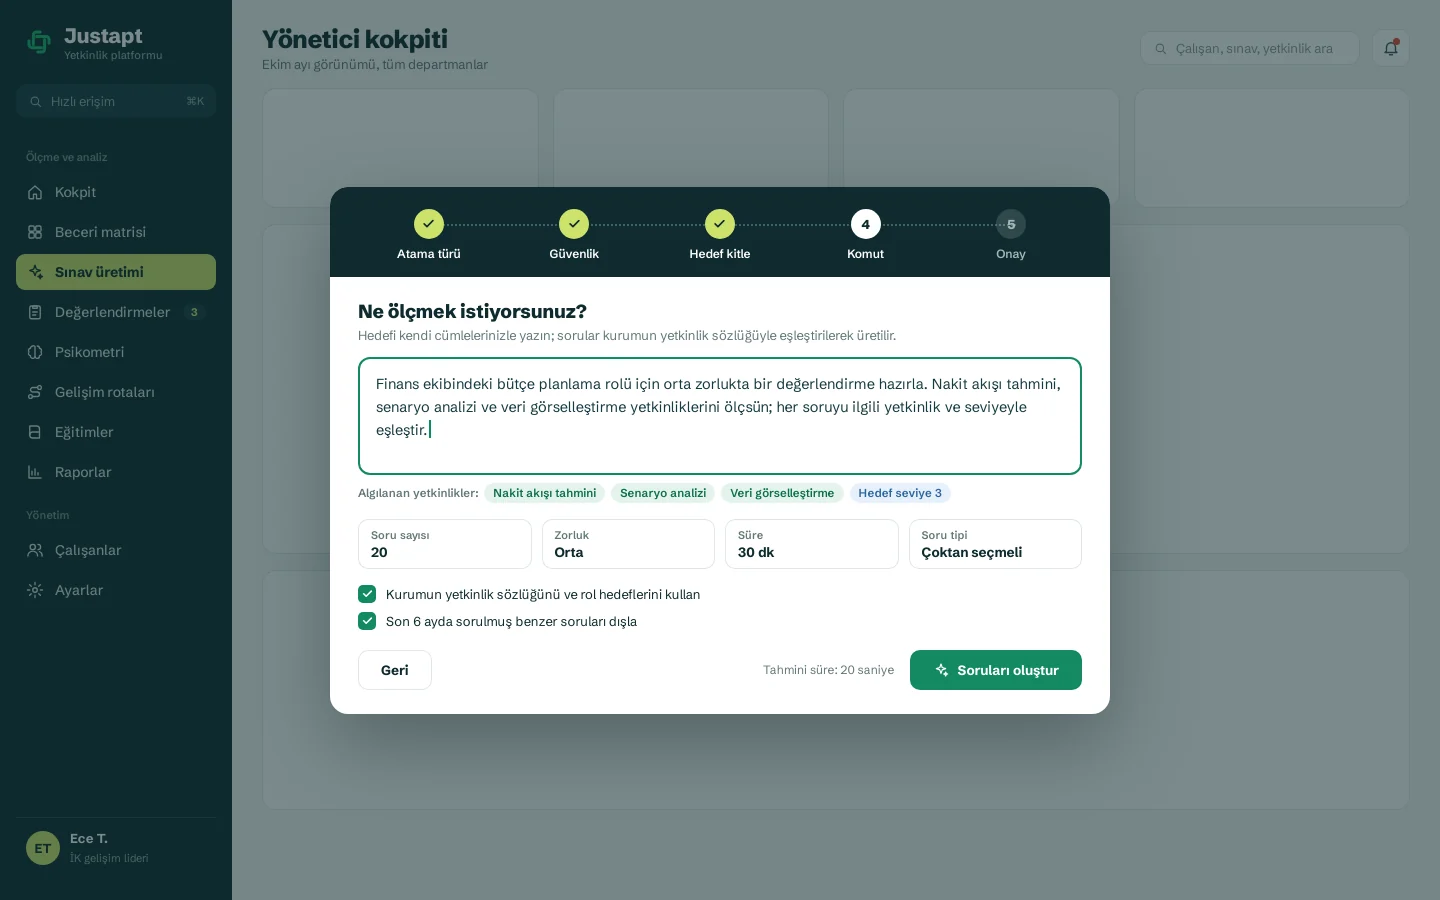
يتقدم إنشاء الاختبار عبر معالج من خمس خطوات: نوع الإسناد، ومستوى الأمان، والفئة المستهدفة، والأمر، والتأكيد. وفي خطوة الأمر يكتب المدير ما يريد قياسه بجملته الخاصة. ويفحص النظام قاموس الكفاءات وأهداف الأدوار وبنك الأسئلة؛ فيكتشف من النص الكفاءات ذات الصلة ويعرضها على المدير مع إعدادات الإنشاء. وعند التأكيد تصبح الأسئلة، وكل منها مرتبط بكفاءة وبمستوى، جاهزة للمراجعة في ثوانٍ.
قد يبدو ارتباط السؤال بكفاءة تفصيلًا، لكن قيمة النظام كلها تأتي من هنا. فالنتائج تتدفق لاحقًا إلى مصفوفة المهارات والدرجات الوظيفية ومسارات التطوير عبر هذا الارتباط. أما السؤال غير المرتبط بكفاءة فلا يضيف شيئًا إلى التحليل مهما كانت صياغته جيدة.
يقع الاختبار في منتصف سلسلة أوسع. فخلف كل خطوة يخطوها المستخدم عملٌ ينفّذه النظام: فعند تسليم جرد الموارد البشرية تُدرَج مصفوفة المؤسسة في النموذج، وتُوائَم مطابقة الموضوعات ومخرجات التعلّم مع قاموس الكفاءات، ويُعَدّ الاختبار ببنية تكيّفية تختار الأسئلة بحسب المستوى. وبعد أن يؤدي الموظف الاختبار يبحث تحليل الكفاءات الجذرية عن السبب الحقيقي للفجوة، وتتكوّن خريطة التطوير الفردية، ويُنشَر التقرير النهائي بعد أن يمرّ برقابة الخبراء. ولا تُنقل البيانات يدويًا في أيٍّ من هذه الخطوات الثماني.
الكلمة الأخيرة للخبير قبل النشر
يمكن لسؤال واحد خاطئ أو غامض يُنشأ تلقائيًا أن يجعل التقييم بأكمله محل جدل. لذلك فإن القاعدة الأساسية للمنصة واضحة: تُنشأ الأسئلة بالذكاء الاصطناعي لكنها تُنشر بموافقة الخبير. ولا يُنشر أي سؤال دون موافقة.
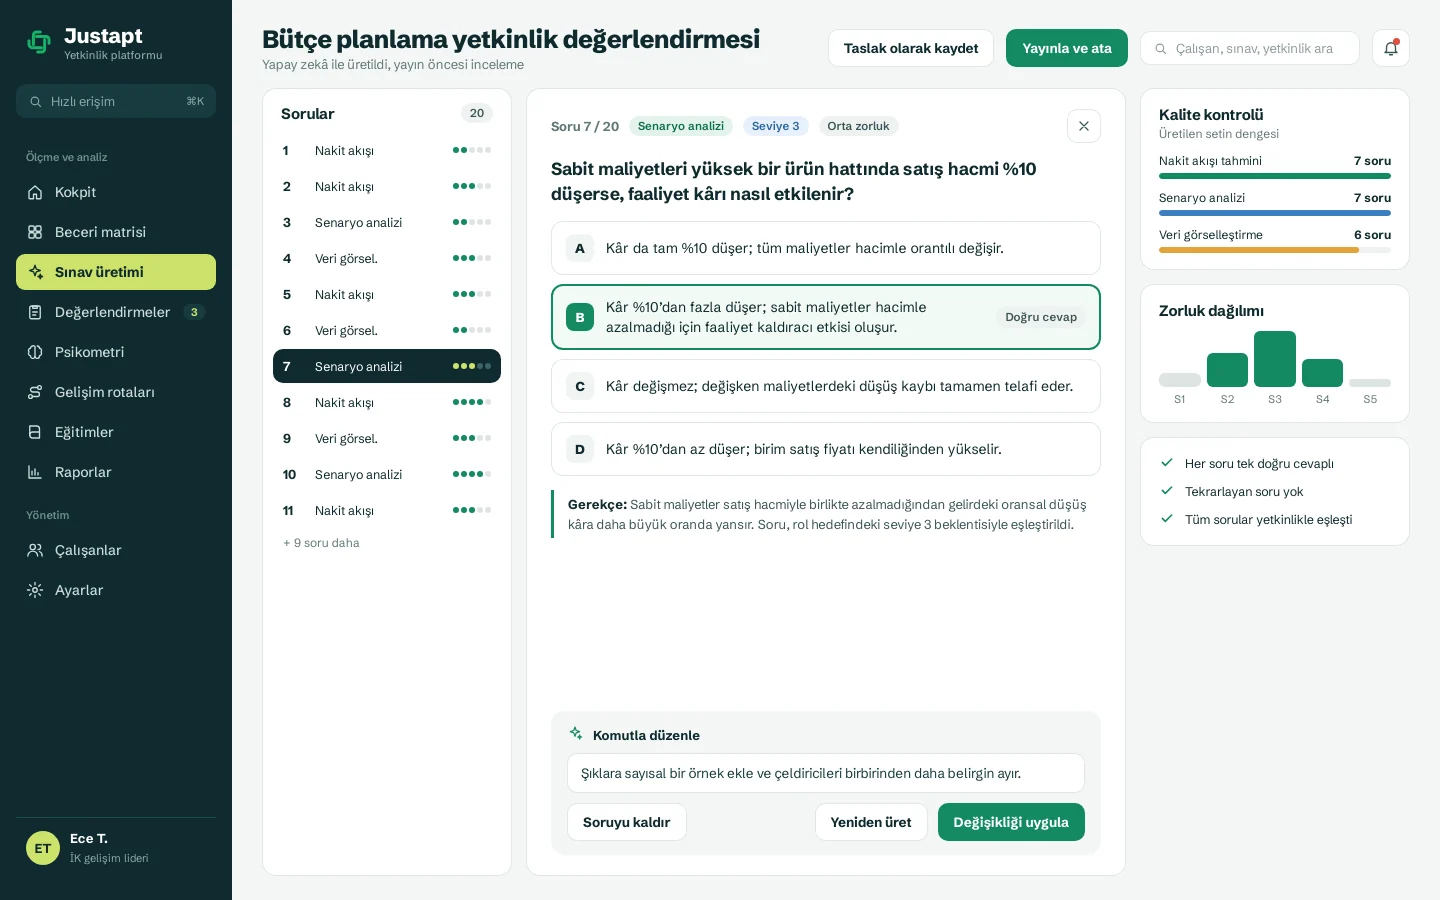
يفحص الخبير كل سؤال على حدة في مستكشف الأسئلة. وإجابة كل سؤال الصحيحة مسجَّلة مع تعليلها ومع المستوى الذي يقيسه؛ ويبيّن التعليل أيضًا بأي توقّع للمستوى في هدف الدور طُوبق السؤال. ويُعدَّل السؤال الذي لا يعجب الخبير بأمر يُعطى بلغة طبيعية؛ وتُحدَّث الخيارات أو الصعوبة أو السياق بهذه التعليمة. وعند الحاجة يُعاد إنشاء السؤال أو يُحذف من المجموعة.
وتعمل في الشاشة نفسها لوحة مراقبة الجودة. ففي كل مجموعة يُبلَّغ تلقائيًا عن توزيع الكفاءات وتوازن الصعوبة ووجود إجابة صحيحة واحدة وفحص التكرار. وهذه اللوحة حاسمة كي لا تفوت الخبير الصورة الكاملة للمجموعة بينما تتركز عينه على سؤال واحد. وعندما تصبح المجموعة جاهزة يستطيع الخبير حفظها كمسودة، أو نشرها وإسنادها إلى الفئة المستهدفة في خطوة واحدة.
لحظة التطبيق: مرن أم مراقب؟
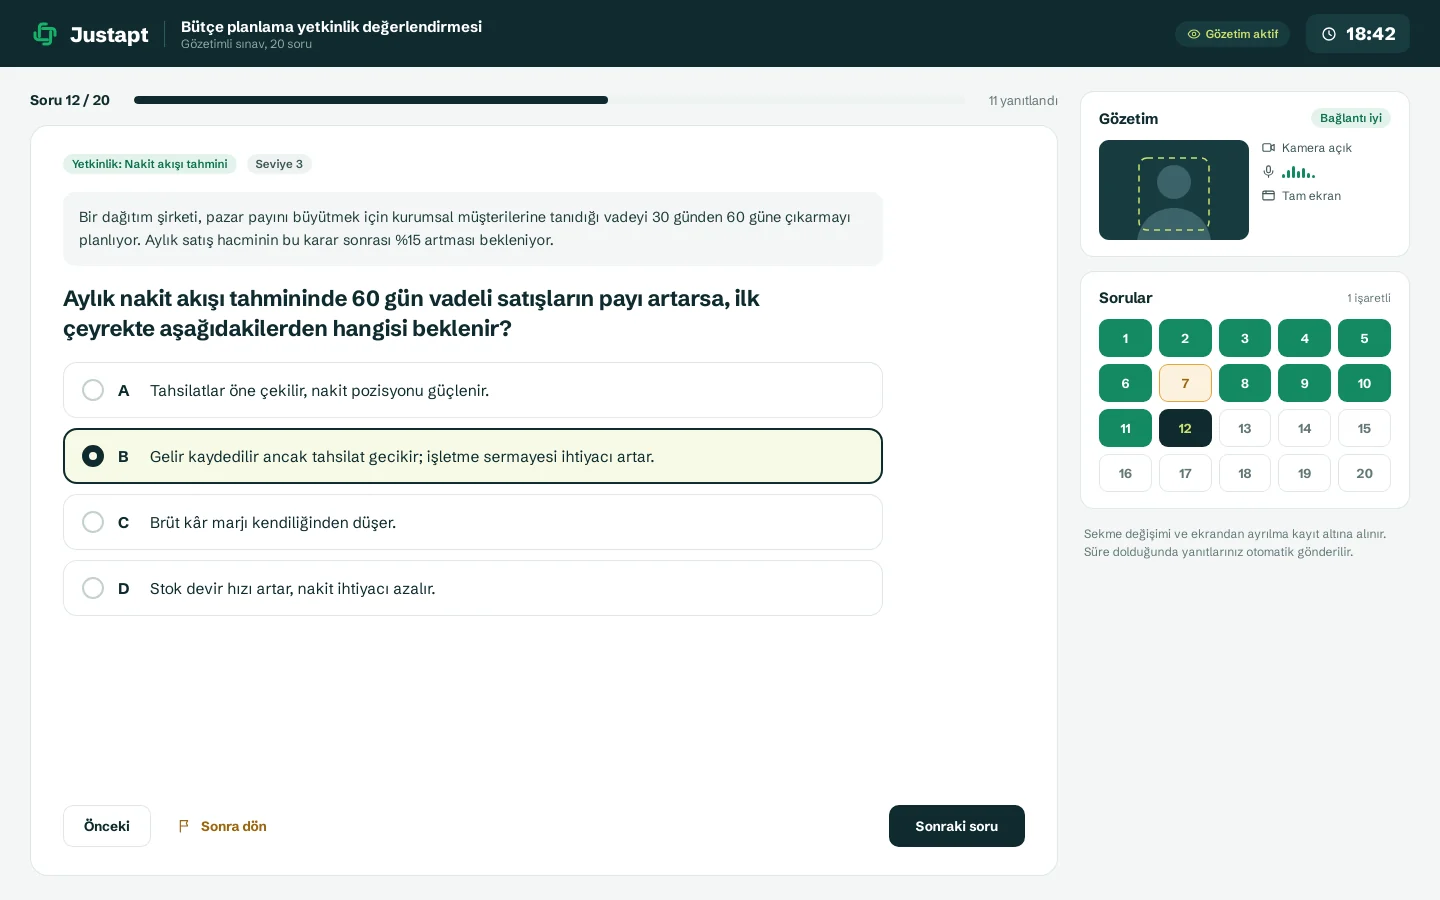
وكان لا بد أن تكون موثوقية الاختبار قابلة للضبط بحسب الغرض. ففي القرارات الحرجة مثل الترقية والتوظيف يجب حماية النتائج من الغش والمساعدة الخارجية؛ أما في القياسات الموجَّهة للتطوير فتُحدث الصرامة نفسها احتكاكًا لا داعي له. ولذلك فإن مستوى الأمان خطوة من خطوات المعالج: إما الوضع المرن أو الوضع المراقب الذي يتضمن الكاميرا والميكروفون وملء الشاشة وتتبع علامات التبويب. ويُعالَج تبديل علامة التبويب ومغادرة الشاشة وتجاوز المدة تلقائيًا.
وعلى جانب الموظف الشاشة بسيطة: عدّاد الوقت وخريطة الأسئلة وأمامه سؤال واحد فقط. وقد صُمّمت الشاشة، كبقية المنصة، وفق معايير إمكانية الوصول WCAG 2.1 AA وبما يلائم قارئات الشاشة. وتُكتب كل إجابة على الخادم فورًا؛ فلا تضيع أي إجابة حتى لو انقطع الاتصال. ويمكن أن يتشكل الاختبار بحسب إجابات المرشح أيضًا: فالمرشح الذي يجيب إجابة صحيحة عن سؤال متوسط المستوى قد يأتيه في الخطوة التالية سؤال أصعب. وتنعكس النتائج تلقائيًا في مصفوفة المهارات والدرجات الوظيفية. وفي التقرير تنقسم الأسئلة بحسب أنواعها أيضًا: تُقيَّم أسئلة الكفاءة العامة والتفكير الاستراتيجي وحل المشكلات والتفكير التحليلي كلًّا على حدة، ويظهر النجاح بحسب مستوى الصعوبة كذلك. وإلى جانب اختبارات المعرفة تُطبَّق في المنصة نفسها مقاييس الشخصية والمرونة النفسية والقدرات المعرفية؛ ولأن منطق احتساب الدرجات فيها يختلف، تُحسب بخوارزميات منفصلة وتجتمع في تقرير واحد للمرشح.
ما تعلّمناه في الميدان
- الذكاء الاصطناعي يسرّع، والخبير يقرّر. فقد حافظت أتمتة الإنشاء وربط النشر بالموافقة على السرعة وعلى الثقة معًا.
- يجب أن يرتبط كل سؤال بكفاءة. فالسؤال المرتبط بالقاموس يواصل إنتاج القيمة بعد الاختبار أيضًا.
- التعليل جزء من السؤال. فتسجيل سبب صحة الإجابة الصحيحة والمستوى الذي تقيسه يسهّل المراجعة.
- يجب أن يتناسب الأمان مع الغرض. الوضع المرن في قياس التطوير، والوضع المراقب في القرار الحرج؛ والاثنان على المنصة نفسها.
قيمة التقييم بقدر قيمة أضعف أسئلته. والطريقة الصحيحة لاستخدام الذكاء الاصطناعي هي أن نبني معه العملية التي تلتقط ذلك السؤال الضعيف قبل نشره.
كم يستغرق إعداد تقييماتكم؟
إذا كان إعداد التقييمات يستغرق أسابيع من فرق خبرائكم، أو كانت لديكم عملية تودّون فيها استخدام الذكاء الاصطناعي لكنكم تخشون فقدان السيطرة، فيمكننا أن نصمم معًا مسار إنشاء بموافقة بشرية. يمكنكم الاطلاع على صفحة مشروع JustApt، كما يمكنكم التواصل معنا.
نبذة عن الكاتب
Selin Kaya
أخصائية المحتوى الرقمي
تعمل أخصائية محتوى رقمي في Karatsoft وتُعدّ مقالات المدوّنة. تشرح بلغة بسيطة الغرض من المنتجات والمشاريع وكيفية استخدامها.

التعليقات
0لا توجد تعليقات بعد. كن أول من يعلّق!
أضف تعليقًا
يسعدنا أن تشاركنا أفكارك وآراءك.